Projet 03 · Intelligence artificielle
Thot
Nos propres modèles d'intelligence artificielle, servis par nos machines, derrière une API que tout outil compatible OpenAI sait appeler.
Conception, serveurs, réglagesEn servicellama.cpp · Python · GPU
Le problème
Brancher une entreprise sur l'IA d'un géant américain, c'est lui confier ses données et dépendre de ses prix. Je voulais nos modèles, sur nos cartes graphiques, en France — et la même façon de les appeler que les grands, pour que n'importe quel outil s'y branche.
Ce que j'ai construit
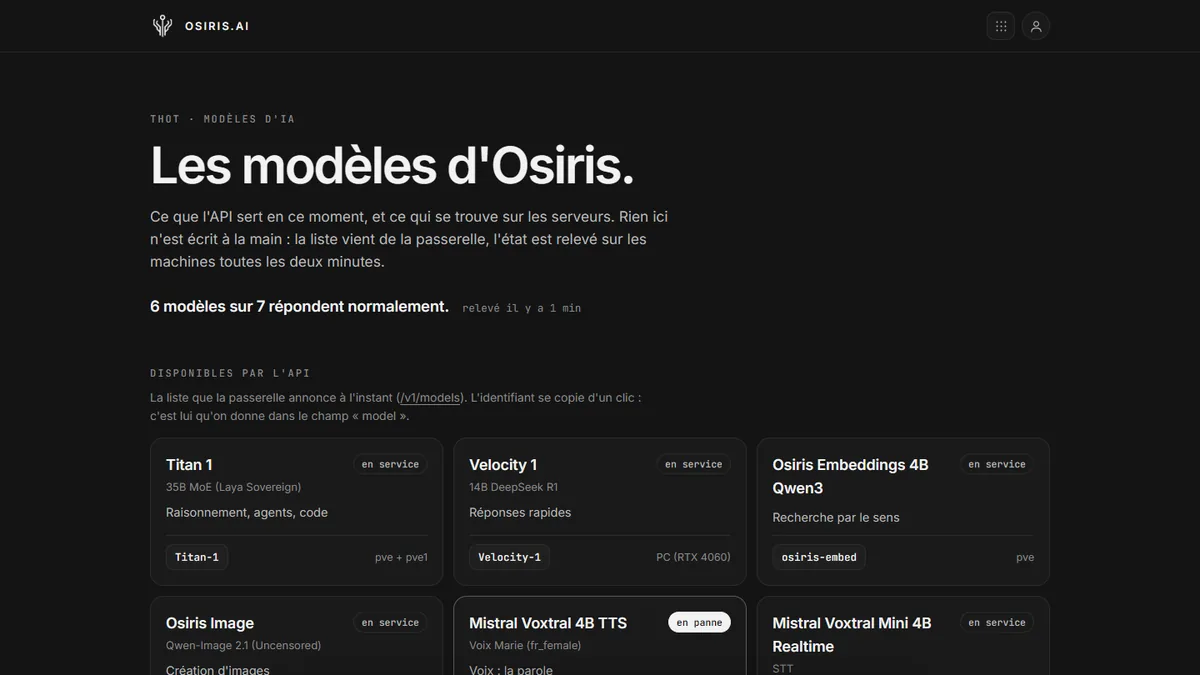
- Une passerelle unique qui annonce les modèles disponibles et envoie chaque demande vers la bonne machine.
- Sept modèles : raisonnement, agents et code (Titan 1, 35 milliards de paramètres, réparti sur deux serveurs), réponses rapides (Velocity 1), recherche par le sens, création d'images, voix (parler et écouter), lecture de documents.
- Une page d'état publique, relevée toutes les deux minutes : rien n'y est écrit à la main, une panne s'y voit.
- Des réglages mesurés : le premier mot de Titan 1 est passé de 6,2 s à 1,2 s (un cache retiré sur un serveur à court de mémoire) ; une réponse courte, de 87 s à 4 s en coupant la réflexion quand elle ne sert à rien.
En chiffres
7modèles d'IA
3machines : deux serveurs et un PC
6,2 → 1,2 spremier mot de Titan 1
87 → 4 sréponse courte, réflexion coupée
Comment
Les modèles tournent avec llama.cpp et d'autres moteurs ouverts, sur des cartes graphiques que nous gérons nous-mêmes ; le plus gros est réparti entre deux serveurs. Chaque réglage est mesuré avant et après, et l'état public vient de la passerelle elle-même.
En direct